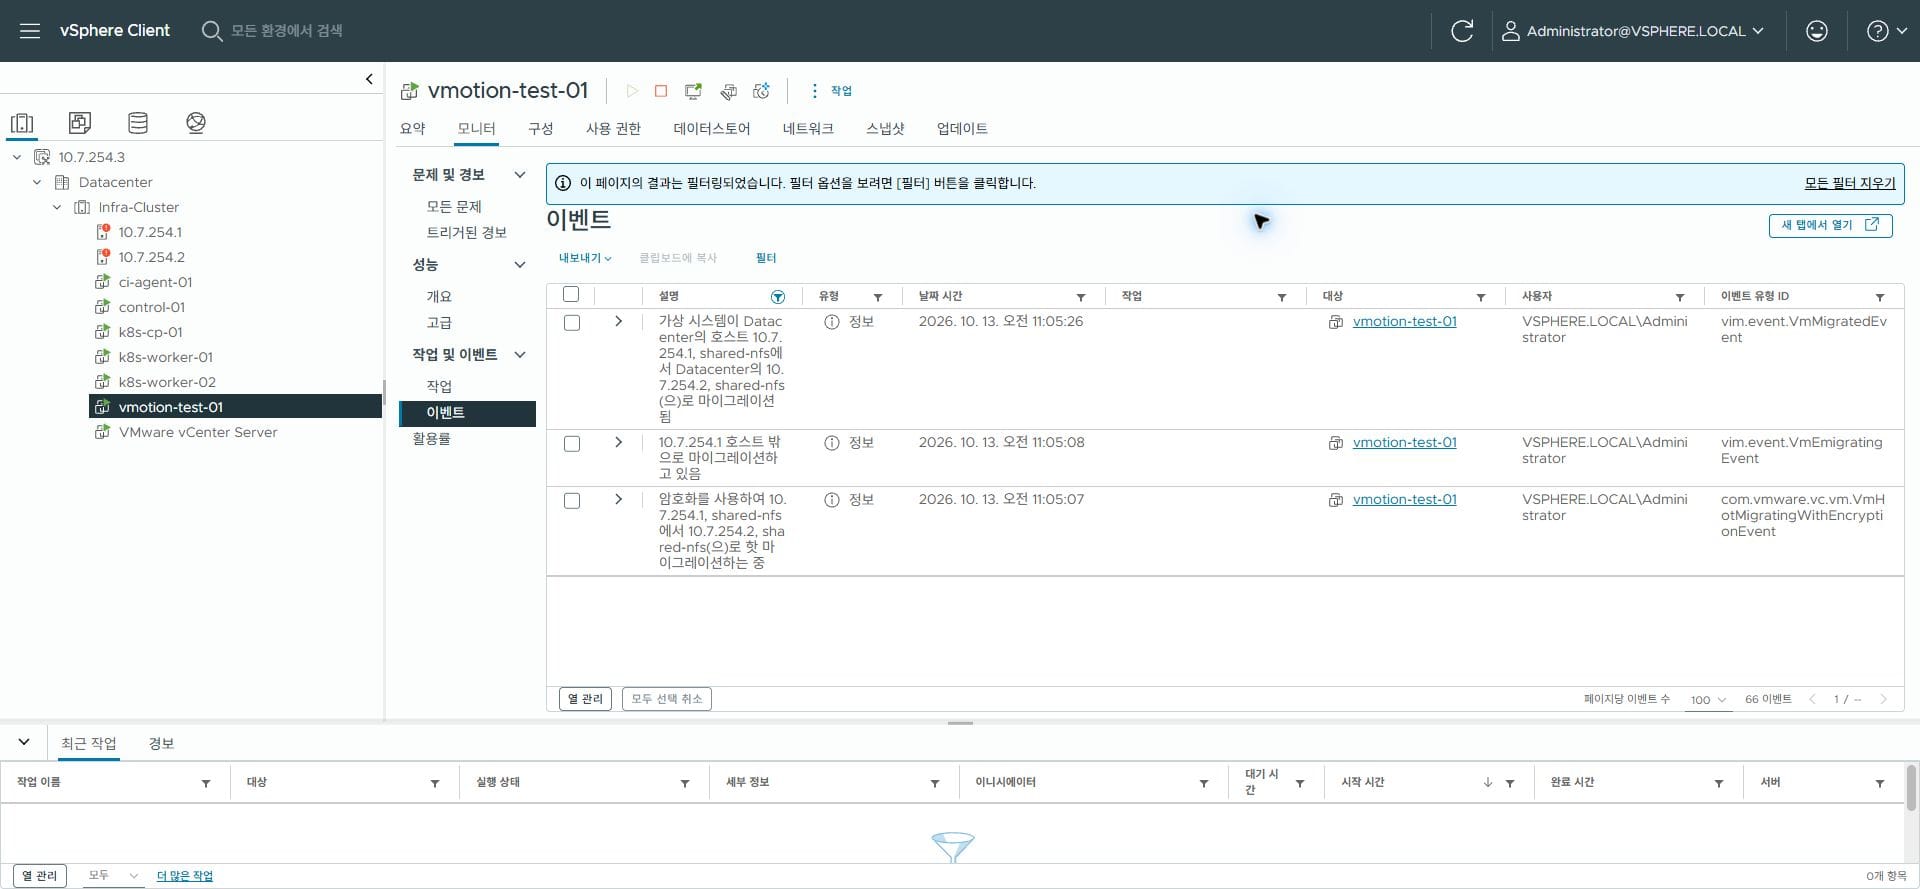
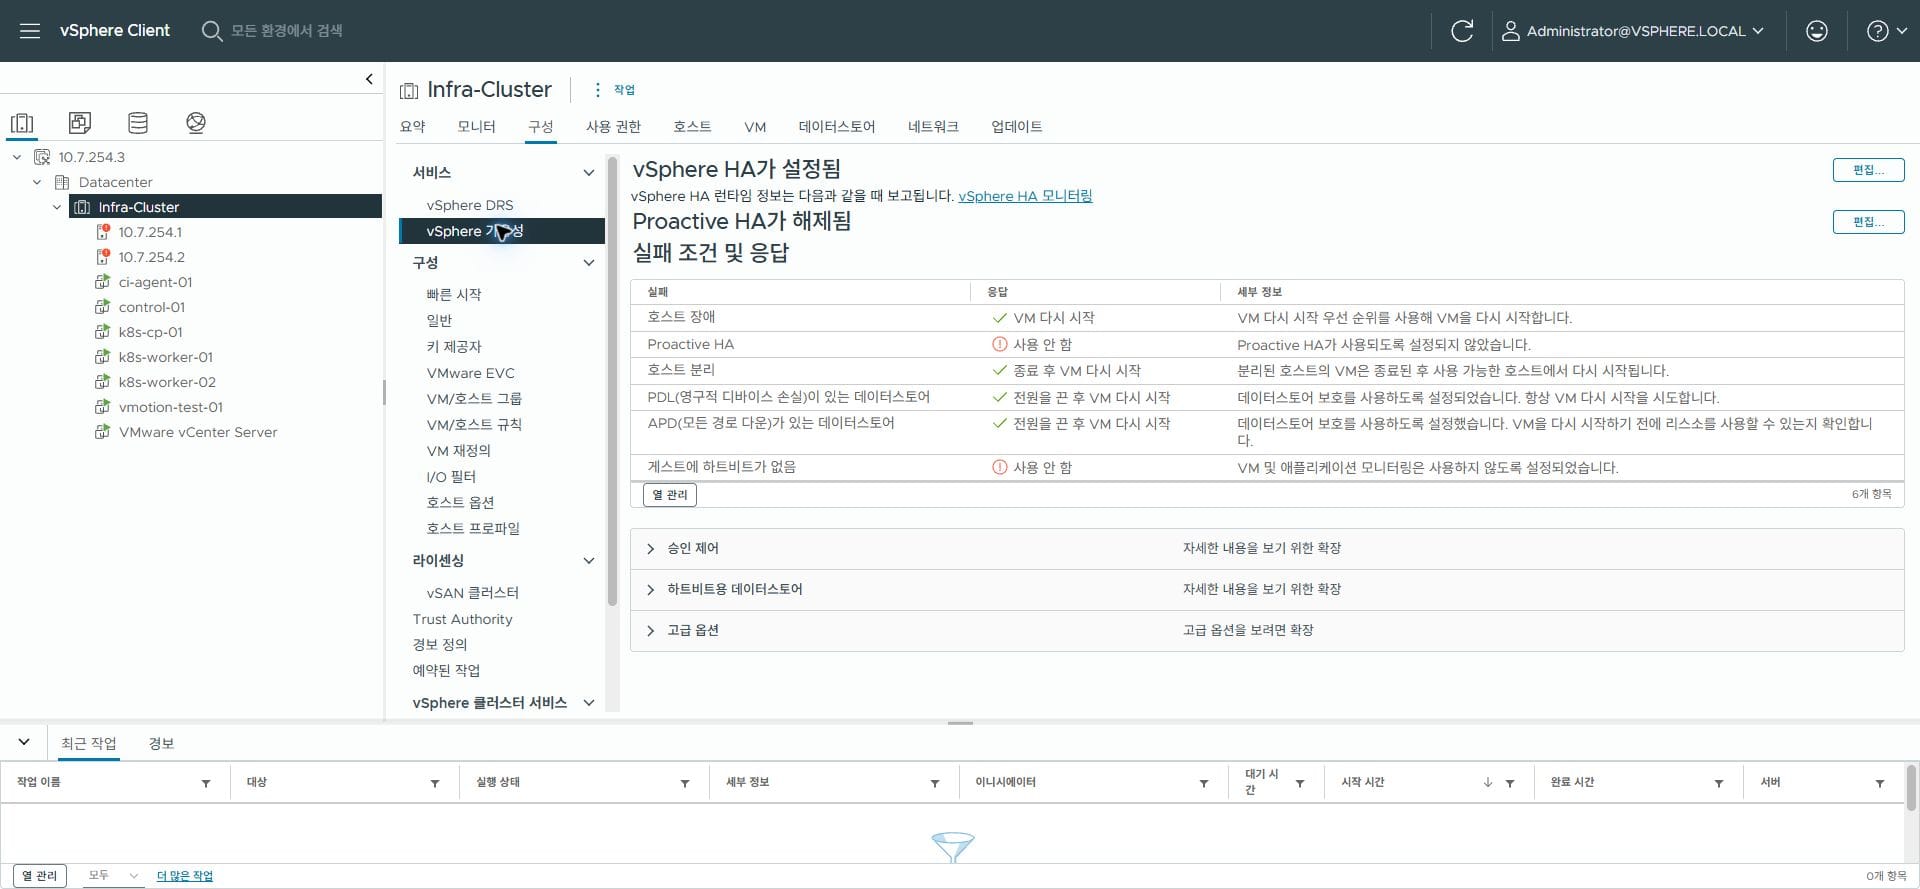
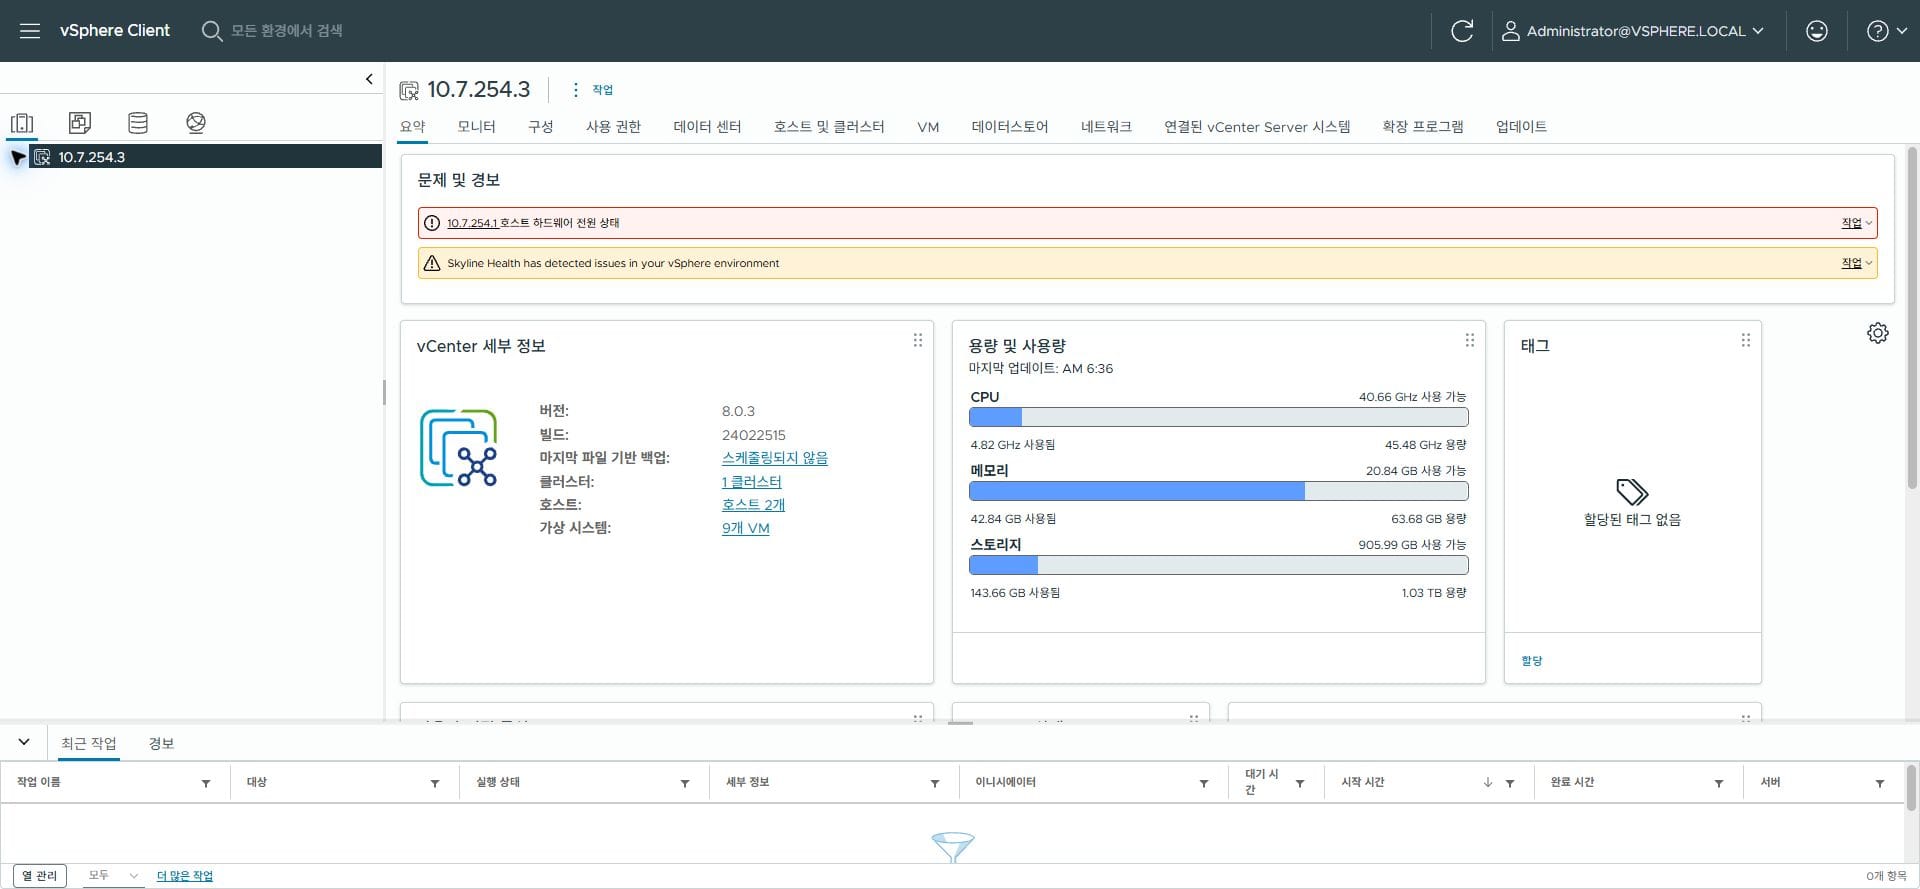
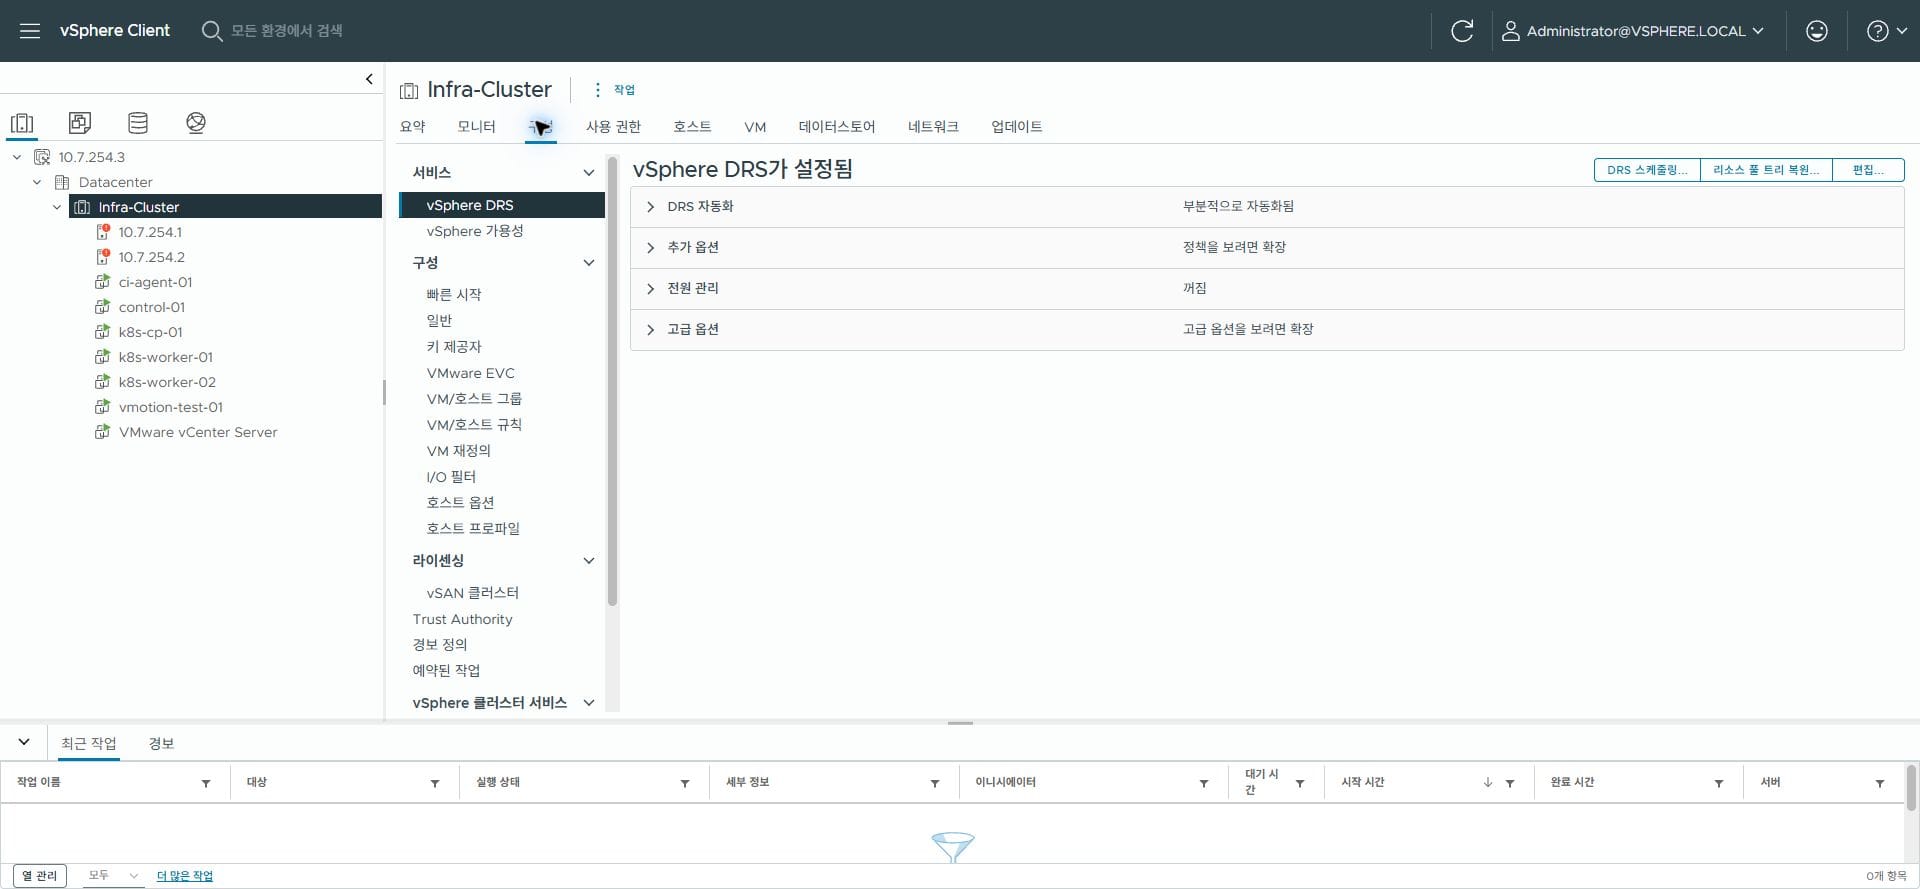
vMotion 이동과 HA 재시작 및 vCenter 접속 복구를 구분한 과정
테스트 VM은 공유 datastore에 CPU 2개, 메모리 2GB, 20GB Thin disk로 생성했다. VM을 만들었지만 설치 ISO를 사용하는 과정에서 콘솔에 다음 문구가 나왔다.
Troubleshooting, Infrastructure, On-Premise
링크는 1Gbps인데 vmkping이 실패한 이유는 비어 있는 uplink였다
이때는 물리 링크와 가상 네트워크 구성이 각각 맞는지 나누어 확인해야 했다. NIC의 불이 켜져 있는 것과 VMkernel의 패킷이 그 NIC로 나갈 수 있는 것은 같은 상태가 아니었다.
Troubleshooting, Network, On-Premise
100Mbps 관리망을 유지하고 vMotion과 NFS를 직결한 과정
대신 트래픽 경로를 나눴다. ESXi 두 대 사이를 vMotion용으로 직접 연결하고, 각 ESXi와 NFS 서버도 각각 직접 연결했다. 모든 서비스망을 기가비트로 바꾼 구성이 아니라 VM 이동과 스토리지 접근에 별도 경로를 만든 것이다.
Troubleshooting, Network, On-Premise
클라우드 대신 ESXi 두 대로 시작한 인프라 자동화 환경
처음 학습 문서에서는 Proxmox와 Harbor, HAProxy, Keepalived도 검토했다. 하지만 실제로 구축하며 선택한 구성은 달랐다. 최종 환경을 설명할 때 처음 그린 그림과 실제 설치한 제품을 섞지 않는 것부터 시작했다.
On-Premise, Infrastructure
온프레미스 RCA Platform 구축기 ESXi부터 승인 배포까지
2026년 10월, ESXi 두 대와 공유 NFS 위에 가상화 환경을 구성하고 Terraform, Ansible, Jenkins, Kubernetes를 차례로 연결했다. 배포 대상으로는 기존에 개발하던 RCA Platform을 사용했다. 인프라 상태를 수집하고 장애 분석과 보고서 생성 흐름을 다루는 애플리케이션이어서, 직접 만든 인프라에
Project, On-Premise, RCA
Cilium DNS timeout의 원인은 NetworkPolicy가 아니었다
OCI와 온프레미스를 Tailscale로 연결한 RKE2 클러스터에서 Cilium DNS timeout을 추적했다. 정책 차단과 TPROXY 반환 경로, fragment DROP을 분리하고 1,355건으로 복구를 확인한 기록이다.
Troubleshooting, Kubernetes, Cilium, RKE2, Tailscale
백업은 성공했는데 복원 검증이 멈췄다: restic 잠금과 MySQL 설정 확인
Ghost 백업을 실제로 복원하면서 restic 잠금 경합과 테스트 MySQL의 시작 오류를 만났다. 백업 생성, 파일 복원, SQL import를 나눠 확인하고 검증 절차를 고쳤다.
Troubleshooting, MySQL, Backup, Kubernetes
ARM에서 MySQL Operator를 배포하며 이미지와 재조정 동작을 확인한 과정
MySQL 8.4.11을 ARM 노드 세 곳에 배치하면서 이미지 태그, 버전 파서, Operator의 재조정 동작을 확인했다. 배포가 된 뒤에도 장애 복구와 버전 변경은 따로 검증해야 했다.
Troubleshooting, Kubernetes, MySQL, Helm
RKE2 관리 연결이 끊겼을 때: Tailscale 경로와 백업 전송을 나눠 확인했다
Ghost를 HA 구조로 옮기던 중 관리 API 연결과 대용량 전송이 간헐적으로 끊겼다. 로그로 확인한 원인 범위, 전송 검증을 바꾼 이유, 아직 확정하지 못한 부분을 남겼다.
Troubleshooting, Kubernetes, Network, Tailscale
MeetBack에서 실제로 겪은 트러블슈팅과 최종 회고
MeetBack에서 겪은 NFS 권한, 복제 연결, 설정 반영, 로그인·실시간 오류를 정리했다. 해결 과정과 최종 검증값, 끝내 남은 문제를 함께 기록했다.
Docker Swarm, MySQL, Observability, Troubleshooting
서비스를 멈추지 않고 Linux 권한과 iptables를 적용한 방법
Ubuntu 10대의 실제 계정과 통신을 조사한 뒤 최소권한과 iptables를 적용했다. 자동 원복을 준비하고 허용·차단 요청을 각각 시험한 과정을 기록했다.
iptables, Tailscale, Docker Security
23개 Target과 21개 Rule로 운영 상태를 증명하기까지
Prometheus 수집 대상 23개와 알림 규칙 21개를 점검했다. 설정 파일 불일치, Grafana 로그인 문제, Telegram 알림 검증과 애플리케이션 관측의 한계를 정리했다.
Grafana, Alertmanager, Alloy
HA 구성 후 직접 멈춰 봤다: DB 전환부터 백업 복원까지
Primary 프로세스를 종료하고, Ghost의 DB 연결을 끊고, 앱을 멈췄다. 실제 content 이동과 외부 백업 SQL 복원까지 시험하며 확인한 결과와 아직 시험하지 않은 범위를 나눴다.
Ghost, MySQL, Kubernetes, Backup, Disaster Recovery
Ghost는 한 개로 두고, DB와 볼륨을 다른 노드로 옮길 수 있게 했다
단일 Ghost에 MySQL 3개와 Router 2개를 연결하고, DB 5Gi씩과 content 10Gi에 Longhorn 3복제를 적용했다. 실행 노드와 저장 노드를 나눠 생각한 이유와 자원 부담을 기록했다.
Ghost, MySQL, Kubernetes, Storage, Replication
Ghost와 MySQL을 올리기 전에 되돌릴 환경부터 만들었다
Ghost 6.63.0과 MySQL 8.4.11로 옮기면서 원본 DB와 콘텐츠를 따로 남겼다. 격리 검증, 쓰기 중단 시점의 백업, 운영 전환 이후의 복구 기준까지 정리했다.
Ghost, MySQL, Migration, Backup, Disaster Recovery
Cloudflare Tunnel과 NPM으로 외부 경로를 이중화한 과정
Cloudflare Tunnel 기본 경로와 NPM 예비 경로를 각각 연결하고 TLS·readiness·WebSocket을 시험했다. 리디렉션과 쿠키에 남은 문제도 함께 정리했다.
Nginx Proxy Manager, TLS, WebSocket
RAID5 NFS와 백업에서 권한 거부를 해결한 과정
NFS에 쓰기 권한이 있는데도 App과 백업에서 접근이 거부됐다. UID/GID와 root_squash를 확인해 수정하고, 두 Worker의 파일 공유와 MySQL 백업 복원을 시험했다.
RAID5, LVM, Linux Permissions, Troubleshooting
VyOS 뒤에 MySQL Primary Replica를 격리한 이유
DB 두 대를 VyOS 뒤 전용망으로 옮기고 GTID·TLS 복제를 구성했다. 라우팅과 NAT, 비밀번호 길이 제한, 복제 재접속을 확인한 과정과 수동 전환의 한계를 기록했다.
MySQL, GTID, Network Segmentation
main 변경분을 운영 이미지로 배포하기까지
main 변경을 일회용 MySQL에서 시험하고 커밋 태그와 digest를 기록해 배포했다. Worker 인증, Secret, NFS와 외부 readiness를 확인한 순서를 정리했다.
Docker, Docker Secret, Flyway
정적 IP 전환부터 Docker Swarm 5노드까지
Netplan의 실제 renderer와 NIC 이름을 확인한 뒤 IP를 한 대씩 바꿨다. Swarm 5노드 배치와 업데이트 정책을 구성하며 생긴 제약을 정리했다.
Docker Swarm, Overlay Network
Google 로그인과 Redis 실시간 모듈에서 정한 신뢰 경계
Google ID Token 검증과 Redis Pub/Sub 공통 모듈을 구현했다. 계정 연결, 복제본 간 이벤트 전달, Presence·세션에 남은 문제와 확인한 범위를 정리했다.
OpenID Connect, Redis, WebSocket
팀장으로서 기능과 운영을 함께 책임진 MeetBack 회고
MeetBack에서 팀장과 인프라 담당을 맡아 구축한 범위를 돌아봤다. 팀의 완료 기준, 일정 때문에 남긴 작업, 마지막 검증과 사용자 기능의 미해결 문제를 기록했다.
MeetBack, Team Leadership, Infrastructure
Cloudflare Tunnel을 기본 경로로, NPM을 예비 경로로 둔 이유
공인 IP를 항상 쓸 수 없는 환경에서 Tunnel을 기본 경로로 선택했다. NPM과 DNS-01 인증서를 준비하고 당시 검증한 범위와 보류한 외부 접속 시험을 정리했다.
MeetBack, Cloudflare, Cloudflare Tunnel, Nginx Proxy Manager, TLS
cAdvisor Dashboard와 Telegram Alert까지 연결한 운영 가시성
cAdvisor 지표와 Telegram 알림을 연결했다. 파이프 때문에 생긴 curl 오류와 Grafana 비밀번호 변경 문제를 확인하고, 알림 발생·해제와 남은 관측 항목을 정리했다.
MeetBack, Observability, cAdvisor, Alertmanager, Telegram
Docker Swarm VIP만으로 해결되지 않은 WebSocket 이벤트 공유
Swarm의 JVM별 SimpleBroker 사이를 연결할 Redis Pub/Sub 모듈을 구현했다. 로컬 우선 전달과 중복 억제, 테스트 범위, 아직 연결하지 못한 기능을 정리했다.
MeetBack, Redis, WebSocket, Spring Boot, Docker Swarm
Prometheus 설정은 맞는데 Target이 없었던 이유
설정 검사와 reload가 성공했는데 Prometheus 대상은 비어 있었다. 호스트와 컨테이너의 파일 해시를 비교해 bind mount 문제를 찾고 설정 검증 순서를 수정했다.
MeetBack, Troubleshooting, Prometheus, Grafana, Observability
백업 파일 생성보다 복원을 먼저 본 MySQL NFS 백업
MySQL 논리 백업을 전용 계정으로 NFS에 저장했다. 마운트 누락과 권한 오류를 확인하고, 체크섬 검사부터 별도 DB 복원까지 시험한 과정을 정리했다.
MeetBack, MySQL, Backup, NFS, Disaster Recovery
RAID5 위에 역할별 NFS Storage를 나눈 이유
하드웨어 RAID5 위에 LVM과 NFS를 구성해 업로드와 백업 역할을 나눴다. 디스크 표시, UID/GID, root_squash, automount를 확인한 내용을 정리했다.
MeetBack, NFS, Storage, RAID, Linux
VyOS로 MySQL DB망을 분리하며 Route와 NAT를 구분한 과정
VyOS로 DB망을 분리하다 외부 통신이 막혔다. Live ISO, 버전별 NAT 문법, commit 실패를 확인하고 라우팅·NAT·재부팅을 나눠 검증한 과정을 기록했다.
MeetBack, VyOS, Network, Routing, Troubleshooting
MySQL 8 GTID·TLS Primary Replica 구축과 수동 Failover 선택
MySQL 8.0.46 두 대에 GTID·TLS 복제를 구성했다. 비밀번호 길이 오류와 주소 변경 뒤 재접속을 확인하고, 데이터 복제·쓰기 차단과 수동 전환 범위를 정리했다.
MeetBack, MySQL, Replication, Troubleshooting, Database
Manager 3대와 Worker 2대로 Docker Swarm을 구성한 이유
Manager 3대와 Worker 2대로 Swarm을 구성했다. quorum, Service DNS/VIP, connector 배치를 확인하고 실제 앱 배포에서 남은 검증을 정리했다.
MeetBack, Docker Swarm, Docker, Network, DevOps
Ubuntu 정적 IP 전환과 Swarm 주소 변경에서 배운 것
nmtui에서 NIC가 보이지 않아 실제 Netplan backend부터 확인했다. 이후 Swarm quorum을 유지하며 IP와 DB·NFS·모니터링 참조를 함께 바꿨다.
MeetBack, Troubleshooting, Linux, Network, DevOps
서버 수보다 경계를 먼저 정한 MeetBack 인프라 설계
MeetBack의 11개 서버 역할을 나눠 설계했다. Swarm, MySQL, NFS, 모니터링과 외부 진입의 선택 이유 및 각 구성에 남은 장애 지점을 정리했다.
MeetBack, Infrastructure, Architecture, DevOps, On-Premise
Google 로그인에서 이메일 대신 sub를 식별자로 선택한 이유
Google ID Token을 서버에서 검증하고 sub로 소셜 계정을 찾도록 구현했다. 동일 이메일 자동 연결을 막고 팀의 2단계 가입 흐름과 통합했다.
MeetBack, Google Identity Services, OpenID Connect, JWT, Spring Boot
MeetBack, 약속을 정하는 순간부터 운영까지 직접 만들어 가는 팀 프로젝트
MeetBack에서 Google 로그인과 Redis 실시간 공통 모듈, Swarm 기반 인프라를 담당했다. 프로젝트 진행 중 구현한 범위와 남은 연동 작업을 기록한다.
MeetBack, Project, Spring Boot, Docker, DevOps
Ghost 블로그가 느려진 원인 분리하기: 테마 중복 조회부터 Cloudflare LAX 라우팅까지
블로그가 느려져 Ghost 렌더링 시간과 외부 접속 시간을 따로 재봤다. 테마의 중복 조회와 점검·백업 부하를 줄였고, Cloudflare의 미국 경유는 캐시로 영향을 줄였다.
Troubleshooting, Ghost, Cloudflare, Kubernetes, Network
Google OAuth 테스트 모드의 7일 refresh token 함정
rclone 인증 후 OAuth 앱의 Testing 상태를 확인했다. 7일 만료 조건과 다른 client에 미치는 영향을 나눠 보고 새 token으로 백업을 검증했다.
Troubleshooting
Ghost를 Docker에서 RKE2 Kubernetes로 이전한 과정
Docker Compose의 Ghost를 RKE2로 옮겼다. Local PV와 배포 리소스를 선택한 이유, 데이터 비교, 트래픽 전환과 rollback 순서를 기록했다.
Kubernetes
Kubernetes Ghost 백업을 복구 가능한 운영 체계로 만든 과정
Ghost의 DB dump와 content를 외부 저장소에 백업했다. 수동·정기 Job을 따로 확인하고 ARM64 노드에서 파일과 SQL 복원을 시험했다.
Kubernetes
Kubernetes PV가 Bound인데도 안심하면 안 되는 이유
PV의 Bound 표시와 실제 디스크 상태를 나눠 점검했다. Local PV의 마운트, LVM, I/O 로그와 앱 응답을 확인하는 예방 점검 기록이다.
Troubleshooting
OAuth는 성공했는데 Drive API가 거절한 이유
Google 로그인과 token 발급은 성공했지만 Drive API 접근이 실패했다. client가 속한 프로젝트의 API 활성화부터 Kubernetes 백업 Job까지 확인했다.
Troubleshooting
rclone Google Drive RATE_LIMIT_EXCEEDED 해결기
백업 Job에 반복된 RATE_LIMIT_EXCEEDED를 조사했다. 전용 OAuth client로 바꾸고 수동·정기 백업과 원격 snapshot 복원까지 확인했다.
Troubleshooting
Rancher 502와 단일 장애점: Tunnel부터 Pod까지 추적하기
Rancher 502를 Tunnel, DNS, Service와 Pod 순서로 확인했다. Rancher와 cloudflared의 노드 분산, Helm 설정 보존까지 함께 정리했다.
Troubleshooting
Cloudflare Tunnel 뒤의 Traefik·Hubble이 열리지 않았던 이유
Tunnel 원점을 Traefik으로 지정한 뒤에도 UI가 열리지 않았다. Hubble Ingress와 Dashboard IngressRoute를 나누고 Host 라우팅을 확인했다.
Troubleshooting
RKE2 Agent의 인증서 만료 경고가 실제 만료가 아니었던 이유
RKE2 Agent에 반복된 인증서 경고를 추적했다. 활성 인증서는 정상이었고 과거 Server 디렉터리가 원인이어서 백업 이동 후 Agent만 재시작했다.
Troubleshooting, Kubernetes, Security
RKE2·Tailscale·OCI LPG 중첩 라우팅 장애 해결기
Ready로 보이는 RKE2 노드에서 통신과 부하 문제가 발생했다. OCI LPG와 Tailscale 경로 중첩을 확인하고 목적지별 Policy Routing을 조정했다.
Troubleshooting, Kubernetes, Network
Durable Analysis Pipeline과 검증된 이미지로 운영 경계를 닫기
Evidence 수신과 RCA 분석을 DB Task로 나눴다. Lease와 Outbox로 재시도 범위를 정하고, 검증한 Commit을 이미지로 발행하는 CI까지 연결했다.
RCA, Platform, Spring Boot, Security
Agent 등록을 Workload Identity와 TokenReview로 강화하기
공유 Bootstrap Token으로 확인할 수 없던 Agent 신원을 TokenReview와 Pod·DaemonSet UID, 이미지 Digest로 검증하도록 등록 절차를 바꿨다.
RCA, Kubernetes, Security, RBAC, Node Agent
Production-like·Blind Corpus로 RCA 품질을 분리 검증하기
Golden, 운영 형태 재현 데이터, Blind 평가를 나눴다. 정답을 분석 뒤에 읽도록 하고, 실제 표본을 평가 데이터로 옮기는 검토 절차를 만들었다.
RCA, AIOps, Audit, Kubernetes
3노드 Agent Fleet를 1시간·5시간 검증하며 본 것
Kind의 Agent 3개를 1시간과 5시간 반복 관측했다. 수집 성공률, RSS 추세, 프로세스 재시작, spool 상태를 함께 확인하고 결과가 적용되는 범위를 남겼다.
RCA, Kubernetes, Node Agent, Observability
RKE2·K3s·kubeadm 검증으로 Collector 호환성 다듬기
RKE2, K3s, kubeadm에서 Collector를 검증했다. runtime socket과 로그 경로 차이를 반영하고, 읽지 못한 정보와 실제 서비스 장애를 구분하도록 보강했다.
RCA, Kubernetes, Node Agent, Linux
실제 Kubernetes 클러스터에서 Node Agent를 안전하게 검증하기
실제 노드의 경로와 권한을 확인하기 위해 read-only preflight와 제한된 canary를 분리했다. 수집 결과뿐 아니라 테스트 범위와 cleanup 상태도 기록했다.
RCA, Kubernetes, Node Agent, Linux
운영 변경을 직접 실행하지 않고 GitOps PR로 추적하기
승인된 Catalog 변경을 GitOps Draft PR/MR로 넘기고 배포 결과와 rollback reference를 추적했다. 중복 생성 방지와 webhook 인증도 함께 정리했다.
RCA, DevOps, Platform, Audit, Security
클러스터마다 다른 임계값과 운영 카탈로그를 분리하기
코드 안에 있던 Collector 조합, Rule 활성화, 권장 조치를 Catalog로 옮겼다. 클러스터별 임계값과 설정 검증, preview, 승인 이력도 함께 정리했다.
RCA, Platform, Kubernetes, DevOps
LLM을 진단 보조로 제한한 RCA 파이프라인 설계
Rule-based RCA 결과 뒤에 LLM 설명 보강을 붙였다. 입력을 줄이고 Evidence ID와 응답 형식을 검증했으며, Provider가 실패해도 기본 Report는 생성하도록 했다.
RCA, LLM, AIOps, Spring Boot
RCA 품질을 감으로 판단하지 않기: Evidence Quality와 회귀 게이트
RCA 신호와 별도로 Evidence의 신선도, Collector 상태, Agent health를 평가했다. 보고서의 신뢰 범위를 표시하고 golden scenario와 회귀 기준을 함께 관리했다.
RCA, AIOps, Observability, Kubernetes
RCA 보고서를 증거 번들로 내보내고 무결성을 검증하기
Report와 Incident를 근거, 신호, 타임라인이 포함된 ZIP으로 내보내도록 했다. redaction 이후 파일 해시를 만들고 manifest와 선택적 HMAC 서명으로 검증하게 했다.
RCA, DevOps, Audit, Security, Report export
Kubernetes Cluster Infra RCA Platform
Kubernetes 노드와 Linux evidence로 RCA report를 만드는 프로젝트다. Agent 수집, Rule 기반 분석, LLM 보강과 Policy 분리를 설계하고 Spring Boot·React 구조로 옮겼다.
Project
Flyway, Incident, Audit까지 묶어 운영 플랫폼으로 다듬기
Spring Boot와 React로 전환한 뒤 Flyway, incident, audit, metric, retention을 정리했다. 기존 DB 승계와 운영 기록의 보존 기준을 함께 다뤘다.
Kubernetes, RCA, DevOps, Flyway, Incident, Audit, Observability, Platform
React 19와 TypeScript로 Web Console 다시 구성하기
Web Console을 React 19와 TypeScript로 다시 구성했다. report에서 근거와 조치 위험도를 보여주는 방식, Vite 개발 환경과 Spring Boot 배포 연결을 정리했다.
Kubernetes, RCA, React, TypeScript, Vite, Bootstrap, Web Console, DevOps
FastAPI를 버리고 Spring Boot로 통합한 이유
초기 FastAPI MVP를 Spring Boot 3.5.15와 Java 21로 옮겼다. 인증, DB, Console, metric을 통합한 이유와 Alembic schema를 이어받기 위해 검토한 내용을 적었다.
Kubernetes, RCA, DevOps, Java 21, Spring Boot, FastAPI, Migration, Platform
RCA 플랫폼을 관리 가능한 형태로 다듬기
cluster 삭제에 권한과 이름 확인 절차를 붙이고 RCA report JSON export를 추가했다. 실행 방법과 기능이 달라진 부분은 README에도 반영했다.
Kubernetes, RCA, DevOps, AIOps, Docker, Report export, Platform, Documentation
Docker Compose로 RCA 플랫폼 실행 구조 묶기
당시 FastAPI Backend, DB, Web Console을 Docker Compose로 묶었다. 환경별 설정과 migration 순서를 정리하고 smoke test로 컴포넌트 연결을 확인했다.
Kubernetes, RCA, DevOps, Docker, Docker Compose, FastAPI, Web Console, Deployment
RCA 결과를 운영자가 이해할 수 있게 만들기: Web Console 설계
RCA 결과를 확인할 Web Console을 만들었다. 목록에서 상세 근거로 이동하는 흐름, 조치의 policy 표시, Backend 연결 실패와 빈 상태를 구분하는 화면을 정리했다.
Kubernetes, RCA, DevOps, Web Console, AIOps
Node Agent를 Kubernetes에 올리기: DaemonSet, Helm Chart, 그리고 검증 구조
Node Agent를 노드마다 배포할 DaemonSet과 Helm Chart를 정리했다. hostPath, 권한, token, Collector 설정을 나누고 Backend와 Console까지 연결되는 smoke test를 구성했다.
Kubernetes, DevOps, RCA, Node Agent, DaemonSet, Helm, Smoke Test, Linux
RCA 플랫폼에 인증과 드릴다운을 붙이면서 배운 것
RCA 파이프라인에 로그인과 RBAC, webhook 인증, report drilldown을 붙였다. Collector가 읽지 못한 정보와 실제 runtime 장애를 구분하는 실패 처리도 정리했다.
Kubernetes, Linux, RCA, AIOps, Security, RBAC, Webhook, Node Agent, DevOps
Kubernetes Cluster Infra RCA Platform 개발 기록 1편
노드와 Linux 계층의 evidence로 Kubernetes 장애 원인을 좁히는 RCA 플랫폼을 시작했다. FastAPI MVP, DB 저장, Agent 수집, Rule 기반 분석과 정책 분류의 초기 흐름을 적었다.
Kubernetes, Linux, RCA, DevOps, AIOps, Node Agent, LLM, Codex
DevOps 블로그를 직접 Ghost로 운영하기 시작했다
Ghost 블로그를 직접 운영하기 시작했다. 글을 쓰는 곳이면서, Linux와 컨테이너를 다루다 겪은 문제를 남겨두는 공간으로 쓰려고 한다.
[하이브리드 Kubernetes 구축기 6] “5대 모두 Ready” 다음에 확인할 것: 운영 검증과 회고
5노드 구축 후 etcd membership, Cilium, metrics와 Tailscale 경로를 확인했다. 상태 조회로 확인한 결과와 아직 수행해야 할 장애·복구 시험을 나눠 정리했다.
Kubernetes, Infrastructure, Observability, Disaster Recovery, Audit
[하이브리드 Kubernetes 구축기 5] DNS, etcd, Cilium, iptables를 끝까지 추적한 기록
RKE2 부팅 시 DNS 경합, etcd learner 잔류, Cilium 초기화 실패와 iptables 차단을 겪었다. 각 증상을 어디서 확인했고 무엇을 바꿔 검증했는지 명령어와 함께 남겼다.
Troubleshooting, Incident, Network, Kubernetes, Bootstrap
[하이브리드 Kubernetes 구축기 4] Cilium 패킷은 어떻게 흐를까: eBPF, VXLAN, Tailscale 이중 캡슐화
Cilium의 Service 처리와 VXLAN 경로를 확인했다. 온프레미스 구간에서 Tailscale이 한 번 더 캡슐화하는 과정과 MTU 1280, 원격 Pod 경로 1230을 적용한 이유를 정리했다.
Kubernetes, Network, Observability, Infrastructure, Troubleshooting
[하이브리드 Kubernetes 구축기 3] Tailscale은 정확히 어디에 쓰일까: 실제 경로 추적
관리 접속, RKE2 최초 등록, 온프레미스의 subnet routing을 나눠 Tailscale 경로를 확인했다. OCI 내부 통신과 라우터 장애 전환의 범위도 함께 정리했다.
Kubernetes, Network, Routing, On-Premise, Infrastructure
[하이브리드 Kubernetes 구축기 2] 2025년, RKE2 3 Control Plane과 etcd를 구축하다
OCI의 세 노드에 RKE2 Control Plane과 embedded etcd를 구성했다. membership, quorum, API readiness를 확인하고 DNS 등록 주소가 맡는 역할을 정리했다.
Kubernetes, Infrastructure, Bootstrap, Audit, Architecture
[하이브리드 Kubernetes 구축기 1] 2024년, 홈랩에서 개인 클라우드 설계를 시작하다
집에서 쓰던 서버와 OCI를 함께 관리하려고 하이브리드 Kubernetes를 설계했다. 비용, CPU 아키텍처, 네트워크 경계와 etcd 배치를 어떻게 나눴는지 정리했다.
Kubernetes, Infrastructure, Architecture, On-Premise, Project